구글, '제미나이 3.8 TTS'로 목소리 설계와 대화 연출 활용 지원
Google’s Gemini 3.8 TTS models let users design voices and direct spoken scripts, but voice replication requires consent and multi-speaker production has limits.
구글의 제미나이 3.8 TTS 모델은 목소리를 설계하고 대본의 연기를 조절할 수 있지만, 목소리 복제에는 동의가 필요하며 다중 화자 제작에는 제약이 있습니다.
구글(Google)이 음성 합성 모델 '제미나이 3.8 플래시 TTS(Gemini 3.8 Flash TTS)'와 '제미나이 3.8 플래시 라이트 TTS(Gemini 3.8 Flash-Lite TTS)'를 공개하면서, 텍스트를 읽는 음성의 목소리와 연기 방식을 직접 설계하는 도구를 선보였습니다.
활용의 출발점은 낭독할 대본을 준비하고 목소리를 고른 뒤, 문장마다 감정과 말하는 속도를 조정해 시제품을 들어보는 것입니다.
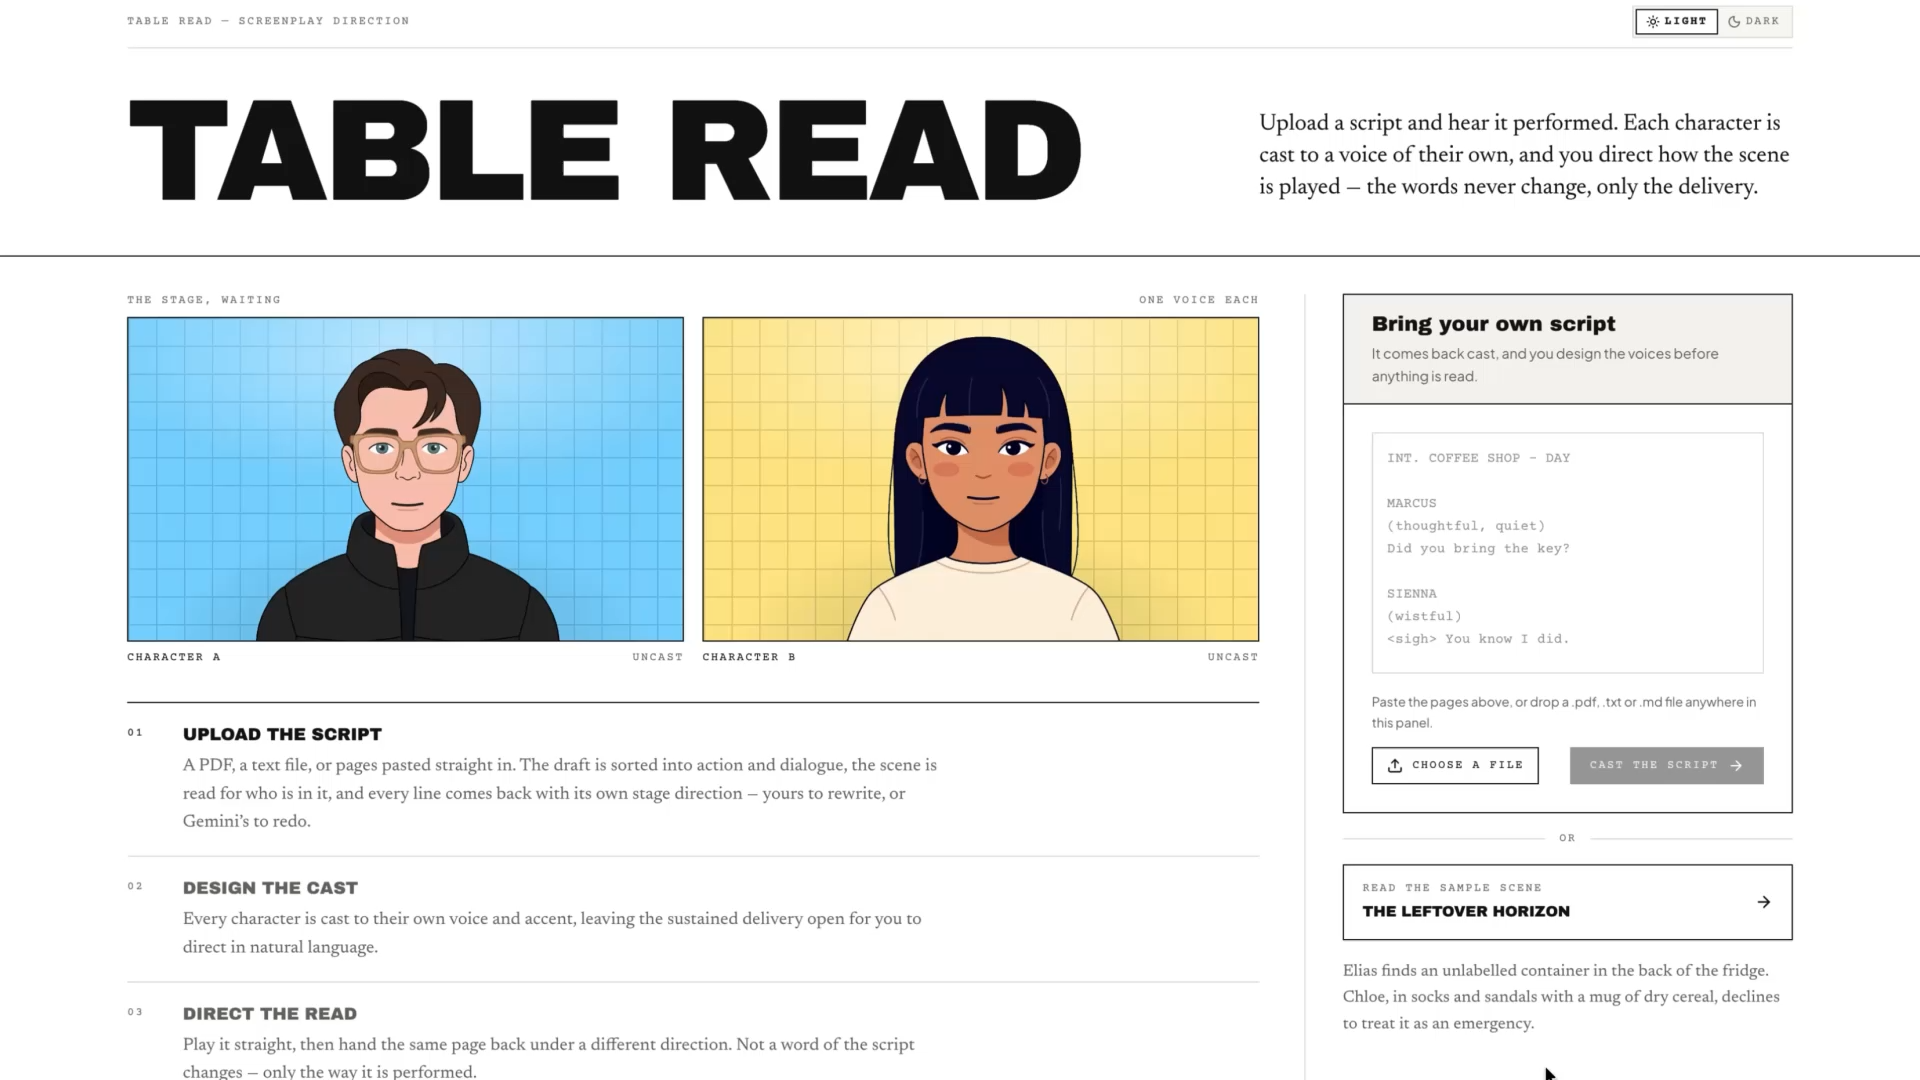
개발 경험이 없는 이용자도 구글 AI 스튜디오(Google AI Studio)의 음성 생성 도구에서 새 목소리를 설명으로 만들거나 자신의 목소리를 복제하고, 두 사람이 대화하는 대본 편집기에서 발화를 조정할 수 있습니다.
모델을 고를 때는 오디오북·극중 대화처럼 세밀한 연출이 필요한 작업에 플래시 TTS를, 대량 더빙·반복적인 읽어주기 기능처럼 처리량과 비용이 중요한 작업에 플래시 라이트 TTS를 맞추는 것이 구글의 권장 용도입니다.
한 사람의 안내 음성을 만들려면 먼저 실제로 읽힐 문장을 입력하고, 준비된 목소리나 새로 설계한 목소리를 선택한 다음 발화 스타일을 지정하면 됩니다.
예를 들어 제품 안내문에는 차분한 상담원 같은 목소리를 설계하고 각 문장의 전달 방식을 '따뜻하고 또렷하게'처럼 지정할 수 있으며, 순간적인 웃음이나 한숨은 대본 안의 별도 음성 태그로 조절할 수 있습니다.
새 캐릭터 목소리가 필요하다면 역할·억양·음색을 자연어로 설명해 음성을 만든 뒤 저장해두고, 오디오북의 여러 장이나 시리즈 콘텐츠에 같은 목소리를 이어 쓸 수 있습니다.
구글의 TTS 개발 문서에 따르면 두 모델 모두 한국어를 지원하므로 한국어 대본으로 먼저 발음과 억양을 시험해볼 수 있습니다.
두 사람이 주고받는 팟캐스트나 드라마라면 화자별 대사를 나누고 서로 다른 기본 목소리를 지정한 다음, 각 차례에 차분함·긴박함 같은 연기 지시를 붙여 대화 흐름을 조절할 수 있습니다.
웃음·한숨·짧은 쉼 같은 표현과 상대 말에 호응하는 소리를 넣을 수 있어, 정보 전달용 낭독과 상황극을 같은 대본 안에서 다르게 연출할 수 있습니다.
서비스에 음성 기능을 넣는 개발자는 제미나이 API(Gemini API)에서 두 모델의 공통 요청 형식을 사용하고 모델 이름을 바꿔 음질 중심 설정과 대량 처리 중심 설정을 비교할 수 있습니다.
일반 이용자에게는 플래시 TTS가 제미나이 노트북(Gemini Notebook), 플래시 라이트 TTS가 구글 비즈(Google Vids)에 순차 제공되며, 기업용 제미나이 엔터프라이즈(Gemini Enterprise) API 제공은 추후 예정돼 있습니다.
기존 사람의 목소리를 재현하려면 구글의 목소리 복제 안내에 따라 당사자의 깨끗한 음성 샘플 10~30초와 별도로 녹음한 동의 음성을 제출해야 합니다.
구글은 복제 과정에서 음성 소유자의 동의를 확인하고, 생성된 음성에는 신스아이디(SynthID) 워터마크를 넣어 AI 음성임을 식별할 수 있도록 한다고 설명합니다.
제작 과정의 제약도 있어 한 번의 요청으로 만드는 두 화자 대화에는 기본 제공 목소리만 쓸 수 있으며, 직접 설계하거나 복제한 목소리를 함께 쓰려면 화자별 음성을 따로 생성해 이어 붙여야 합니다.
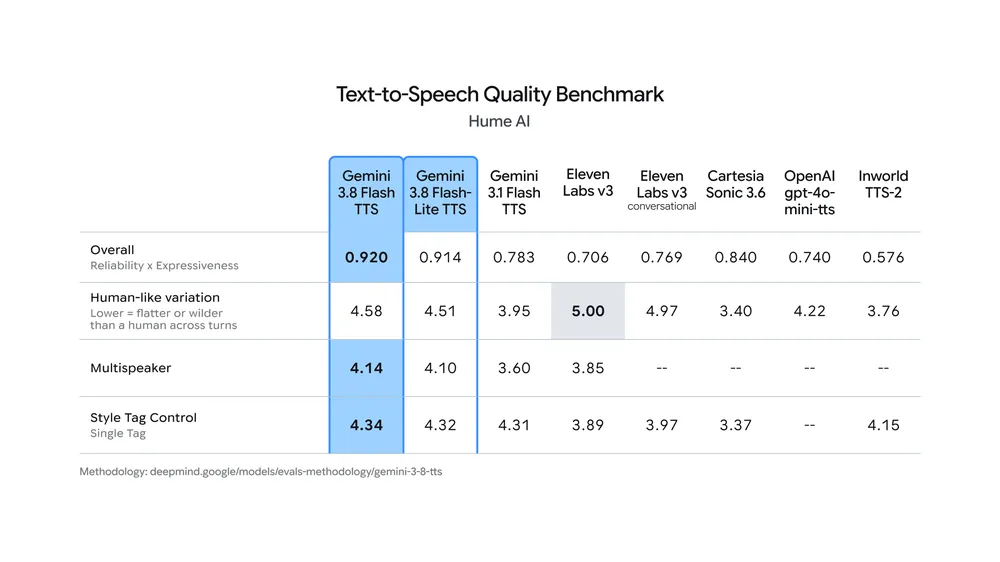
구글은 자사 발표에서 외부 평가의 상위권 성적과 피그마(Figma)·헤이젠(HeyGen) 등 협력사의 더빙 및 음성 서비스 적용 사례를 제시했지만, 실제 결과물의 자연스러움과 제작 비용은 대본·언어·용도에 맞춰 확인할 필요가 있습니다.
따라서 짧은 한국어 원고로 단일 화자 음성을 먼저 시험하고, 필요한 경우 목소리 설계와 대화 연출을 추가하면서 권리 확인과 결과물 검수를 함께 진행하는 방식이 현실적인 활용 순서입니다.
※ 기사 내용 참조
[Google] Gemini 3.8 text-to-speech says hello | by Leland Rechis and Alan Cowen | Sep 23, 2026 | https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-8-text-to-speech/
[YouTube] Create your own voices with Gemini 3.8 text-to-speech | Google DeepMind | https://youtu.be/FL6mI_Br-mc
웨어러블서치
기술이 어디를 향하고 개인과 사회에 어떤 영향을 미치는지 연구합니다.
pf.kakao.com